Pasamos de la imagen al movimiento. Qué modelo usar y cuándo, cómo pensar tus prompts de video, los modos de entrada, character sheets para mantener personajes, y las herramientas que uso para producir tomas de nivel cine.
No hay un modelo "mejor" — hay el correcto para cada toma. Esta es mi guía personal de cuándo uso cada uno.

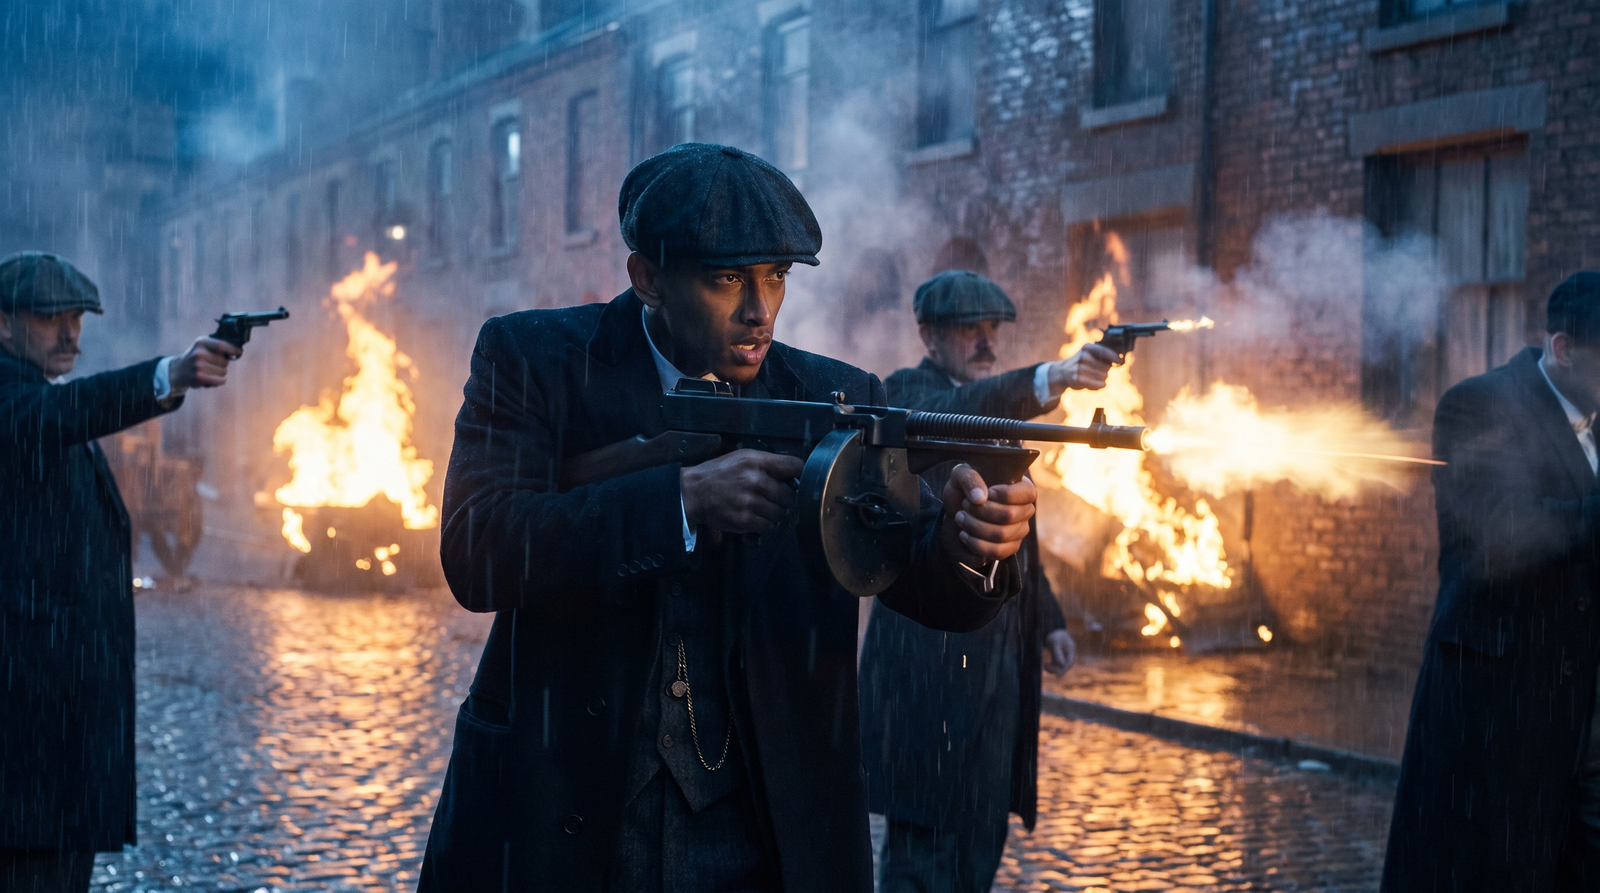
Ideal para: escenas de acción, VFX, tomas con cortes entre planos, y generar planos extra de una escena.

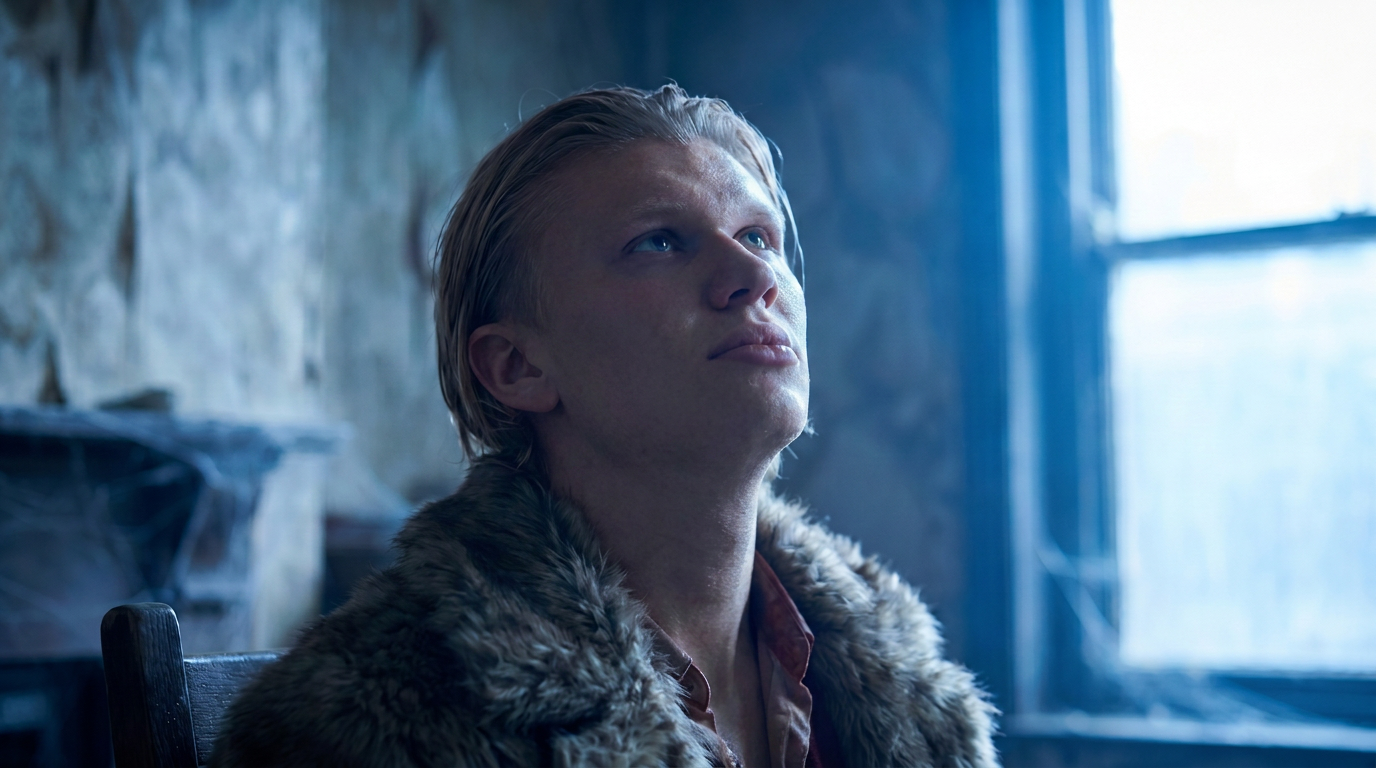
Ideal para: tomas con lip sync básico, expresiones faciales, y su modo Omni (muy útil).
Seedance cuando manda la potencia, la acción o los VFX (y no dependes de una cara famosa). Kling cuando necesitas expresiones, lip sync, rostros específicos o cuidar el presupuesto. Muchos proyectos usan los dos: Kling para los primeros planos actorales, Seedance para los planos de acción.
Para escribir prompts de video complejos (con reglas de filtros, límite de caracteres y formato por shots) conviene el modelo que mejor razona. Puedes usar el GPT personalizado SeedancePro o instalar la skill.
max effort y modo ultra con subagentes)La decisión depende de qué papel juega tu imagen en la toma: ¿es el primer fotograma exacto, o solo una referencia?
Cuando la escena empieza exactamente como está en tu imagen.
Tu imagen es el primer fotograma del video; el movimiento arranca desde ahí. (Nada de @: describe con palabras.)
Cuando la imagen es solo una referencia y la toma real empieza después o con modificaciones.
Tu imagen es una guía, no el punto de partida exacto. Puedes citar cada elemento con @image1, @image2…
Cuando defines un frame inicial y uno final y quieres el recorrido entre ambos.
Marcas de dónde sale y a dónde llega la toma; el modelo construye la transición.
El modo más versátil — y el que más resultados desbloquea. Vale la pena entenderlo bien.
OMNI significa que la toma puede adquirir diferentes inputs a la vez para construirse. En vez de partir de un solo fotograma, combinas varias fuentes:
Si tu escena arranca con el sujeto mirando hacia abajo, pero tu imagen lo tiene mirando a cámara, OMNI hace que empiece desde el rostro abajo — y cuando el rostro sube, no lo deforma: ya conoce cómo es el personaje.
Tienes elementos sueltos y no quieres crear todo plano por plano. Solo el escenario + el sujeto en un character sheet → una foto del entorno y una del personaje, y da un buen resultado.
¿Quieres la voz del personaje o un lip sync con un audio ya existente? Sube archivos de audio con una muestra de la voz — o la voz exacta que quieres usar.
Tienes dos imágenes con elementos separados y quieres que aparezcan juntos en una sola escena — sin tener que generar antes la imagen combinada. También se puede.
¿Una toma quedó incompleta o quieres alargarla? Puedes extenderla con el modo de Seedance (video extension / chaining).
Toma como referencia los últimos 2 segundos de [@tuvideo] y extiende la escena con continuidad visual perfecta. La nueva toma debe comenzar exactamente en el último fotograma del video original, conservando al mismo sujeto, entorno, iluminación, encuadre y movimiento de cámara. Sin cortes ni transiciones visibles, [describe lo que pasa en la escena]. Mantén movimientos fluidos, física realista y coherencia total con la velocidad, dirección y trayectoria de la escena original. No modifiques la apariencia del sujeto, su rostro, cuerpo, vestuario ni ningún elemento importante de la escena.
Reemplaza [@tuvideo] por tu video y [describe lo que pasa] por la continuación de la acción.
Una hoja de personaje (close-up, cuerpo entero y perfil) es la mejor referencia para que tu personaje se mantenga idéntico en todas las tomas. Este es el prompt que uso para generarla.
Hoja de personaje de UN SOLO personaje, organizada en una única fila horizontal sobre un fondo blanco puro (#FFFFFF). La fila contiene exactamente 3 tomas del MISMO personaje, en este orden exacto de izquierda a derecha: 1. CLOSE-UP DEL ROSTRO — retrato cerrado de frente, cámara perfectamente centrada a la altura de los ojos, mirada directa hacia el lente, expresión neutral, cabeza y hombros visibles, proporciones faciales precisas y detalles claros del rostro, piel y cabello. 2. CUERPO COMPLETO DE FRENTE — figura completa visible de pies a cabeza, de pie en una postura natural, brazos relajados a los costados, pies ligeramente separados, cuerpo completamente orientado hacia la cámara, cámara perfectamente centrada y a la altura de los ojos. 3. PERFIL LATERAL — vista lateral pura de 90 grados, cuerpo completo visible de pies a cabeza, cámara perfectamente alineada con el costado del rostro y del cuerpo, solo un ojo visible, brazos relajados, postura natural, con el cabello, la oreja, la nariz, la mandíbula, la silueta del vestuario y el calzado claramente visibles. Las 3 tomas deben mostrar exactamente el mismo diseño de personaje, sin variaciones entre imágenes. Mantener idénticos los rasgos faciales, peinado, tono de piel, edad, proporciones corporales, vestuario, accesorios, materiales y colores de la imagen de referencia. Usar iluminación de estudio neutral, suave, frontal y difusa en las 3 tomas, con sombras mínimas y sin contraste dramático. El fondo debe ser completamente plano, uniforme y blanco puro. Las tomas deben estar distribuidas de manera uniforme en una composición horizontal limpia. Sin texto, sin etiquetas, sin bordes, sin marcos, sin objetos adicionales y sin otros personajes. Usar [PERSONAJE DE REFERENCIA] como sujeto. Preservar con máxima precisión su identidad y apariencia visual en las 3 tomas.
Reemplaza [PERSONAJE DE REFERENCIA] por tu sujeto (o pásalo como imagen de referencia).
Cuando tienes una toma muy abierta con todos los personajes y quieres que la cámara haga un close-up de cada uno, el character sheet lo hace posible: el modelo puede acercarse a cualquier rostro sin deformarlo, porque ya conoce cómo es cada personaje.
Un prompt de video sólido se arma por bloques. Estas son las categorías esenciales, en orden — desglosarlas así te da control total sobre la toma.
El género y estilo de la toma — define todo el look.
Quién es, qué hace, e incluido su diálogo (siempre entre comillas).
enciende un cigarro y dice: "…"El lugar, la atmósfera y los detalles del set.
campo de tierra, cielo gris nubladoCómo se mueve la cámara en la toma.
push-in lento · tracking · órbitaEfectos visuales y de sonido que ambientan la escena.
neblina, ruido de ciudad, lluviaEl modelo genera la voz automáticamente — pero tú tienes que decirle cómo debe decir las cosas. Ese detalle es lo que separa un diálogo plano de uno que se siente real.
El diálogo SIEMPRE debe ir entre comillas "…". Así el modelo sabe exactamente qué debe pronunciar el personaje.
Usa [Audio1] como referencia de voz y genera el siguiente diálogo manteniendo exactamente el mismo tono, timbre, acento, ritmo e intención. La frase que dice es: "[Tu dialogo]" Acento latino, debe sonar natural, expresiva y perfectamente integrada con el audio de referencia, sin alterar la identidad de la voz.
Reemplaza [Audio1] por tu archivo de voz y [Tu dialogo] por la frase (entre comillas). Ideal con el modo OMNI de Seedance.
La misma estética que trabajamos en la Clase 1, ahora respirando: cámara, luz y grano fílmico en movimiento.
Ejemplos reales generados con estos flujos — mismo personaje y estética cinematográfica de la Clase 1.
La skill SeedancePro para dominar Seedance 2.0: modos de entrada, reglas de filtros, formato por shots, límite de caracteres y consistencia de personaje. Instálala en Claude Code o úsala como GPT.
Convierte tu idea en un prompt de video profesional con el formato de 6 secciones, reglas de filtros y límite de 1,990 caracteres — listo para Seedance 2.0.
Imagen + video, cada semana en vivo. +250 creativos aprendiendo a producir cine con IA de verdad.
Unirme al Club · $35/mes ↗