El nuevo modelo de video de ByteDance genera hasta 30 segundos en una sola toma continua, con diálogos en español sincronizados y hasta 50 referencias dirigiendo cada detalle. Aquí está todo: dónde usarlo, cómo funciona por dentro, cómo escribir el prompt y las recetas listas para producir.
Seedance 2.5 es el modelo de generación de video de ByteDance (los mismos de TikTok y CapCut), lanzado el 31 de julio de 2026. El salto que importa: antes encadenabas clips de 15 segundos con costuras visibles — ahora el modelo sostiene una sola toma continua de 30 segundos con su audio ya sincronizado.
Dreamina anuncia "salida 4K", pero el modelo genera nativo a 480p o 720p — el 4K es un escalado posterior. Por eso todos los agregadores (Freepik, Higgsfield, OpenArt, fal.ai) solo te ofrecen 480p y 720p. No está mal: 720p escalado con un buen upscaler se ve excelente. Solo debes saber qué estás comprando.
La clase la damos en Higgsfield — pero conviene conocer el mapa completo, incluida Dreamina, la casa oficial de ByteDance, que regala créditos diarios para practicar.
higgsfield.ai — aquí vamos a trabajar. Integró Seedance 2.5 con el sistema completo de referencias, audio nativo y el mejor precio por clip de los agregadores.
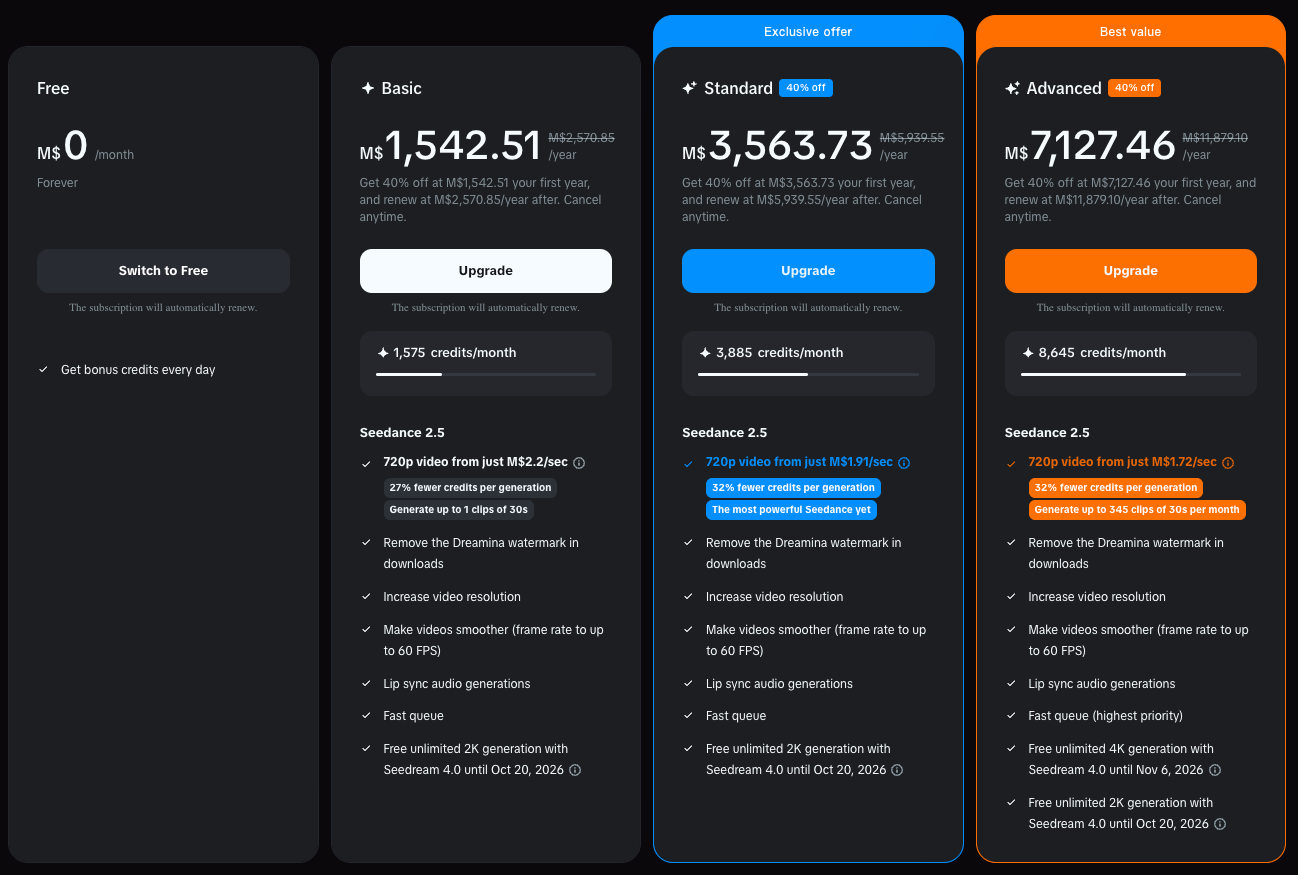
dreamina.capcut.com — la plataforma oficial de ByteDance. Acceso completo al modelo: edición regional, extensión y el modo beta de video largo (180s).
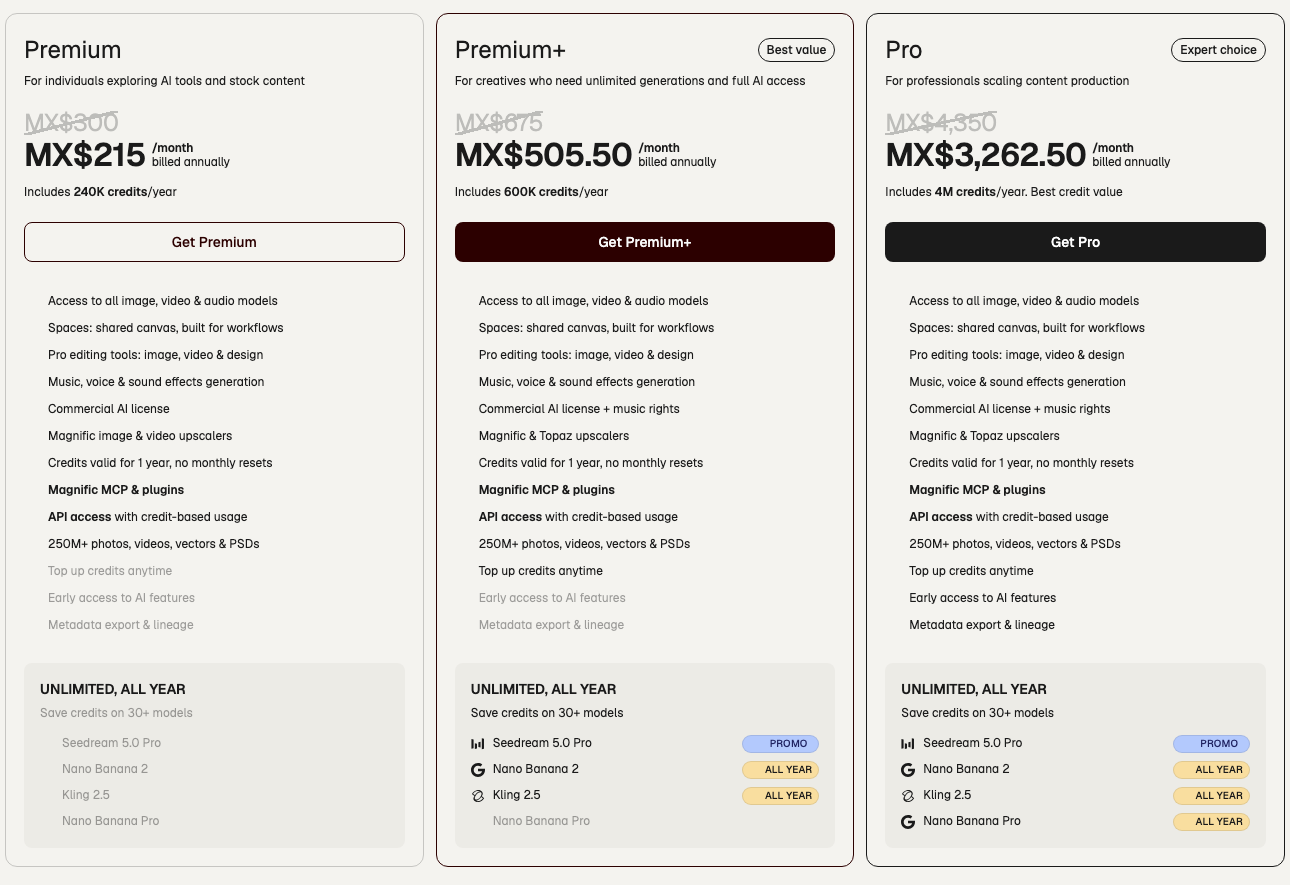
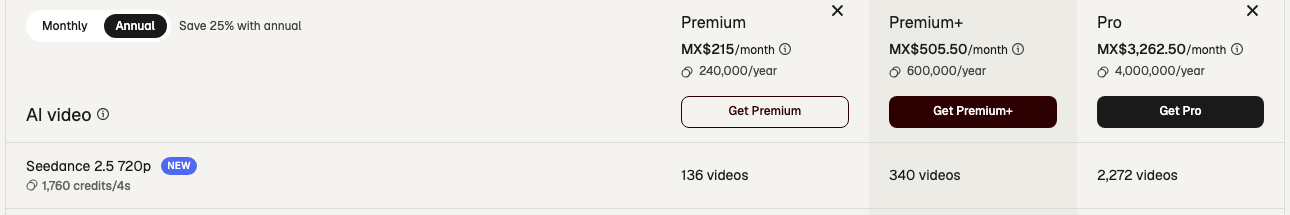
Referencias completas, multishot y 52 presets de cámara. Sus planes ya están en MXN: Premium MX$215/mes y Premium+ MX$505.50/mes con pago anual (MX$300 y MX$675 si pagas mes a mes). Un clip de 10s en 720p = 4,400 créditos exactos.
Disponible con audio nativo: 5s en 480p con audio = 300 créditos. Para resoluciones mayores la propia plataforma recomienda otros modelos.
fal.ai: ≈$0.46 USD por segundo en 720p (≈$0.22 en 480p), también en Replicate. La API oficial es BytePlus ModelArk, con facturación por tokens.
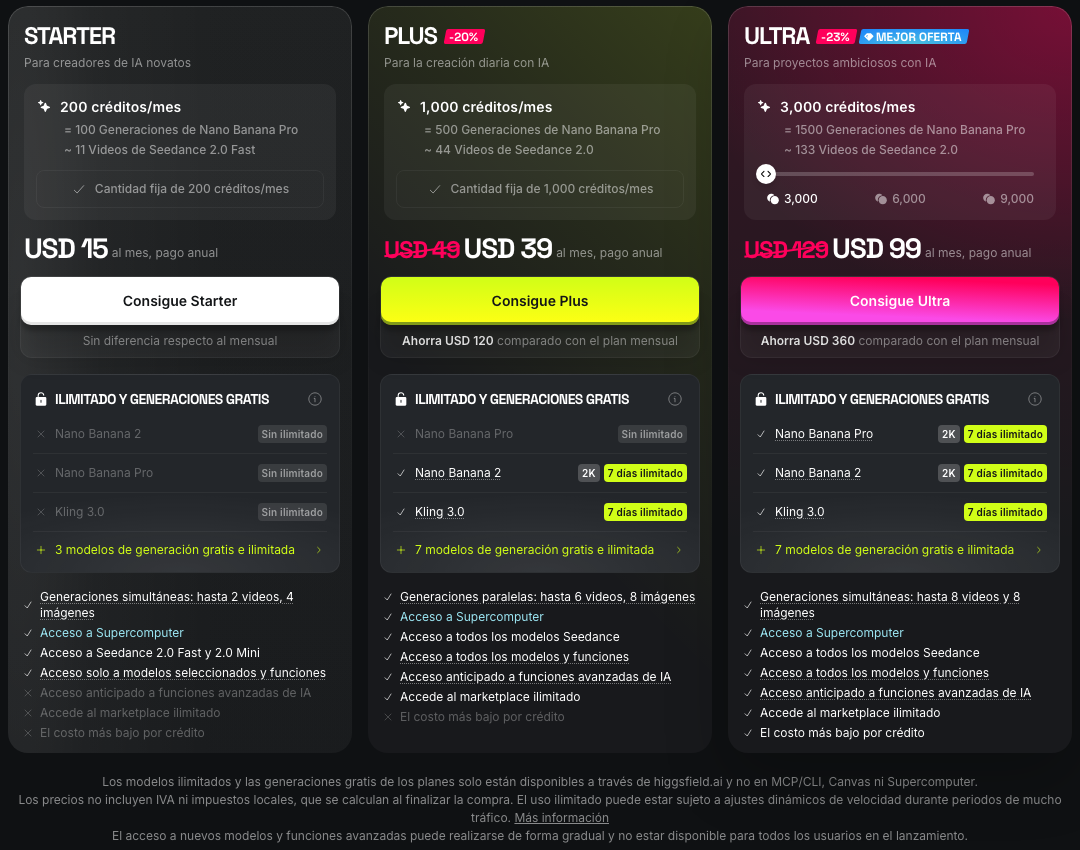
¿Estás en la clase? Higgsfield, con plan anual si quieres el acceso ilimitado a Seedance 2.5. ¿Quieres gratis o el clip más barato? Dreamina: créditos de regalo diarios, y con plan el clip de 10s sale desde ~MX$22. ¿Ya pagas Magnific (Freepik)? Funciona, y sus planes ya cobran en pesos. ¿Eres dev? fal.ai o la API de BytePlus. Krea todavía no lo tiene. Precios capturados el 11 de agosto de 2026 — esto cambia rápido.
Toda generación arranca desde uno de estos tres caminos: solo texto, una imagen que se convierte en el primer cuadro, o referencias que fijan identidades. Lo demás — edición regional, keyframes, multishot — son herramientas de dirección que se montan encima.
Describes la escena y el modelo la inventa completa. Máxima libertad, mínimo control sobre rostros, productos y detalles.
Tu imagen es literalmente el cuadro 1 del video, y de ahí todo cobra vida. Control total de la composición inicial.
Aquí tus archivos no son el primer frame: son la identidad. Imágenes que fijan personaje y producto, videos que enseñan la cámara, audios que marcan el ritmo — y el modelo genera escenas nuevas con todo eso consistente.
Sobre cualquier video ya generado: señalas una zona o ventana de tiempo y describes el cambio. La luz, la cámara, el audio y todo lo demás quedan intactos.
La versión con dos anclas de "algo que ya tienes a video": das el cuadro inicial y el final, y el modelo construye el viaje entre los dos. No se combina con las referencias de imagen/video.
En vez de una toma continua, diriges hasta 6 tomas de 1 a 12 segundos en una sola generación, con los cortes donde tú digas (así lo expone Freepik).
Esta es el arma secreta de Seedance 2.5: cada generación acepta hasta 30 imágenes, 10 videos y 10 audios dirigiendo el resultado. Las imágenes fijan identidades y estilos, los videos enseñan lenguaje de cámara, y los audios marcan el ritmo y el lip-sync.
El modelo necesita saber qué dirige cada archivo. Dilo explícito en el prompt: identidad del personaje, producto exacto, locación, solo paleta de color, solo ritmo.
Asigna tus referencias en este orden: primero los personajes centrales, luego los productos clave, después el escenario y al final el estilo general.
Los rostros de referencia deben ser ilustración, render 3D o retrato generado con IA — nunca la foto de una persona real. Es regla de filtros y también de ética.
Para una campaña o serie: congela el set de referencias — mismas imágenes, mismo orden, mismos roles — y repite palabra por palabra la descripción del personaje en cada prompt.
En 2.5 una sola pista de voz o música puede dirigir toda la toma: los cortes caen en los beats, el movimiento sigue el tempo y el lip-sync se alinea a la voz. Sube un MP3 como referencia y decláralo: @ref5 [MP3] — rol: ritmo, cortes en los beats.
La regla número uno: cada línea del prompt describe algo que la cámara ve o el micrófono escucha. Nada de emociones, intenciones ni backstory — "está nervioso" no existe; "manos inquietas, respiración rápida, mirada que se desvía" sí.
Nivel de realismo + cámara real (ARRI, RED, iPhone) + lente + luz + textura + grade de color. Y el plan de cámara con sus tiempos.
Locación, superficies, clima, elementos atmosféricos (polvo, neblina, reflejos) y el sonido ambiente antes de que pase nada.
Rol + referencia + apariencia física + lenguaje corporal como acción visible. Nunca pensamientos ni personalidad.
La toma partida en ventanas de tiempo: qué hace la cámara, qué se ve, qué hace el sujeto y qué se escucha en cada ventana.
Idioma, diálogos con hablante + tono + timecode, música, SFX y prioridad de mezcla.
Visual Style: Cinematic realism, ARRI Alexa, 35mm, atardecer dorado con neón encendiendo. Grano de película sutil, vapor de comida en el aire. Grade teal-orange. Camera Behavior: single continuous 30s take — slow dolly push 0:00-0:10, hold at medium 0:10-0:22, settle on hero frame by 0:30. Environment: Mercado nocturno mexicano, puesto de tamales con foco colgante. Piso de concreto húmedo reflejando el neón. Papel picado moviéndose con el aire. Sonido ambiente: murmullo del mercado, un comal chisporroteando. Personaje: Vendedora based on @ref1 [ilustración estilizada] — rol: personaje principal. Delantal bordado, trenza con listón, manos trabajando rápido sobre el comal. Take (0:00-0:30) 0:00-0:10 — Dolly push desde la calle hacia el puesto. El vapor cruza el cuadro. La vendedora destapa la vaporera. Sonido: siseo del vapor. 0:10-0:22 — Cámara sostiene en medium. Ella sirve un tamal, lo envuelve. Dice (tono cálido, 0:14): "Recién salidos, güerito. Pásele." 0:22-0:30 — La cámara se asienta. Ella extiende el tamal hacia cámara, el neón la ilumina de lado. El ambiente del mercado se sostiene. Audio (native, synced): Language: español mexicano. Diálogo como está marcado arriba. Music: son jarocho suave, entra 0:00, baja bajo el diálogo. SFX: vapor 0:04, comal constante. Mix: diálogo sobre música.
Las plataformas ya aceptan prompts larguísimos (hasta 10,000 caracteres en Freepik), pero 2.5 entiende mejor las instrucciones que 2.0 — lo que premia es la precisión, no el relleno. Si una línea no pasaría en el shot list de un director, bórrala. Y evita marcas, personajes con copyright y famosos: el filtro los bloquea.
Seedance 2.5 genera video y audio en un solo paso: diálogo con lip-sync, música, foley y ambiente, sin sincronizar nada en post. Habla 11 idiomas — incluido el nuestro.
Quién habla + tono + timecode. Máximo 8 palabras por línea — el español corre rápido y el lip-sync sale más limpio.
Género, tempo y dónde entra y sale. "Son jarocho suave, entra 0:00, resuelve en 0:28".
Efectos puntuales con su timecode: "siseo de vapor 0:04, portazo 0:19". Lo que no marques, el modelo lo improvisa.
La cama de fondo que une la toma: mercado, lluvia, oficina. Descríbela en el Environment, antes de la acción.
Cierra siempre tu bloque de audio con dos cosas: el idioma explícito — Language: español mexicano — y la prioridad de mezcla: Mix: diálogo sobre música (o música al frente, o ambiente al frente). Entre línea y línea de diálogo deja un beat de acción — nada de ping-pong acelerado.
Generar 30 segundos en 720p es caro en cualquier plataforma. El flujo profesional no es "generar hasta que salga" — es un embudo: barato primero, caro al final, y arreglar en vez de repetir.
Prueba la idea en 480p y con menos segundos. Revisas el arco de movimiento, los timecodes y si las referencias se respetaron.
Revisa lo que siempre falla: manos, textos y etiquetas, física de objetos, continuidad. Y que cada acción cayó en su timecode.
¿Quedó 90% bien y una cosa falló? Edición regional: apuntas al elemento roto, describes el cambio y el resto queda intacto. Una corrección por pasada.
Cada video se puede extender hasta 2 veces manteniendo personaje y estilo (misma descripción, mismas referencias). ¿Necesitas 4K de verdad? Escala el 720p con un upscaler.
1) Regenerar 30 segundos completos por un detalle que la edición regional arreglaba. 2) Tirar el render 720p sin haber probado la idea en 480p. 3) Cambiar referencias a mitad de una serie — pierdes la consistencia y pagas por re-descubrirla.
Así se usan: instala la skill del regalo de abajo, toca el pedido de la receta que necesites para copiarlo, pégaselo a Claude con tus datos, y Claude te devuelve el prompt completo — listo para pegar en Higgsfield.
Lo nuevo de 2.5 en su máxima expresión: subes tu canción como referencia y los cortes y la cámara caen en los beats.
El food porn que vende: vapor, close-ups del platillo y manos preparándolo. Para la taquería, el café o tu marca de salsas.
Dolly push + órbita macro + hero frame, con la etiqueta protegida por referencia.
Presentador a cámara estilo "recomendación honesta": gancho → beneficios → CTA en 30s exactos.
La corrección quirúrgica: target, cambio, qué preservar y ventana de tiempo.
Cómo extender una escena y mantener al personaje idéntico en toda una serie.
El método completo de esta clase, empaquetado como skill para Claude. La instalas una vez y le pides tus prompts en español: Claude aplica solo el formato seccionado, los timecodes, las referencias y las reglas de filtros.
Le enseña a Claude a escribir prompts de Seedance 2.5 con toda la metodología de la clase.
Cada semana desarmamos una herramienta nueva en vivo — con recetas, cuentas claras y cero humo. Esta clase es solo una de todas las del Club.
Unirme al Club · $35/mes ↗